初见大模型训练与推理
“一开始看 AI Infra,最乱的其实不是概念,而是工具太多:CUDA、NCCL、DeepSpeed、Megatron-LM、vLLM。顺着大模型真正跑起来的过程去看,这些工具处理的无非是几类问题:显存不够、通信变慢、GPU 跑不满,以及推理时怎么把资源用得更省。AI Infra 关注的,就是这些系统瓶颈”
— 次阅读
目录
1.为什么需要 AI Infra
一次最简单的模型训练,大致只有几步:数据送进模型,完成前向计算,计算 Loss,再反向传播并更新参数。
模型规模小时,一张 GPU 就能承担全部工作。模型继续变大以后,问题开始从“算法能不能训练”变成“系统能不能承受”。
一个训练任务至少同时依赖三类资源:
- Compute(计算):GPU 是否有足够算力完成矩阵运算;
- Storage(存储):数据、模型权重和 Checkpoint 能否及时读取和保存;
- Network(网络):多张 GPU、多个节点之间能否足够快地交换数据。
GPU 利用率
以一块 GPU 为例,真正参与训练的不只有计算核心。模型参数和中间结果通常存放在 HBM(High Bandwidth Memory,高带宽内存)中,Kernel 从显存读取数据,完成计算后再写回。
以 7B 模型为例,如果参数全部使用 FP16,仅模型参数就需要:
训练时还需要保存梯度、优化器状态、激活值以及各种临时 Buffer,因此“7B 参数约 14 GB”只说明了权重本身的大小,并不代表 14 GB 显存就能训练 7B 模型。
数据供给
训练数据一般要经历清洗、去重、过滤、格式转换、Tokenize,再由 DataLoader 送入 GPU。
如果 GPU 的消费速度高于存储系统提供数据的速度,GPU 就会等待 I/O。算力没有变少,但有效利用率会下降。
因此训练系统里会出现数据预取(Prefetch)、缓存(Cache)、并行 DataLoader、数据分片(Sharding)、高速 NVMe SSD,规模更大时还会涉及分布式文件系统和 GPU Direct Storage。
这些技术解决的是同一件事:尽量让计算设备不因为等待数据而空闲。
Checkpoint 与容错
如果一个任务只跑十分钟,进程挂掉以后重新运行通常没什么影响。训练持续几天甚至几周时,机器故障、节点掉线、网络异常都可能发生。
Checkpoint(检查点)因此不只是“保存模型权重”。一个可恢复的训练状态通常还需要模型参数、优化器状态、当前 step、随机数状态和数据读取进度。
Checkpoint 解决的是“从哪里继续”,Fault Tolerance(容错)解决的是“系统出现故障后怎样继续运行”。训练规模越大,这两件事越接近基础设施问题,而不再只是训练脚本里的一个 torch.save()。
资源调度
当一个集群同时运行很多任务时,还会出现另一层问题:哪些 GPU 分给哪个任务,任务什么时候启动,优先级如何决定,节点出故障以后任务是否迁移。
Slurm、Kubernetes、Volcano、Ray 等系统主要处理资源和任务调度;Megatron-LM、DeepSpeed 更关注拿到 GPU 以后怎样组织训练;NCCL 负责 GPU 之间常见的集合通信;CUDA 则更接近单张 GPU 上的实际执行。它们经常同时出现,但所在层次并不相同。
2.分布式训练
模型规模继续增加后,最先遇到的通常是两个限制:单张 GPU 放不下模型,或者虽然放得下,但训练速度无法接受。
多 GPU 训练并不是简单地“多插几张卡”。数据、参数和计算必须重新划分,因此出现了 Data Parallelism、Tensor Parallelism 和 Pipeline Parallelism。
Data Parallelism
Data Parallelism(数据并行,DP)的做法最直观:每张 GPU 都保存一份完整模型,不同 GPU 处理不同的数据。
GPU0:完整模型 + Batch A
GPU1:完整模型 + Batch B
GPU2:完整模型 + Batch C
GPU3:完整模型 + Batch D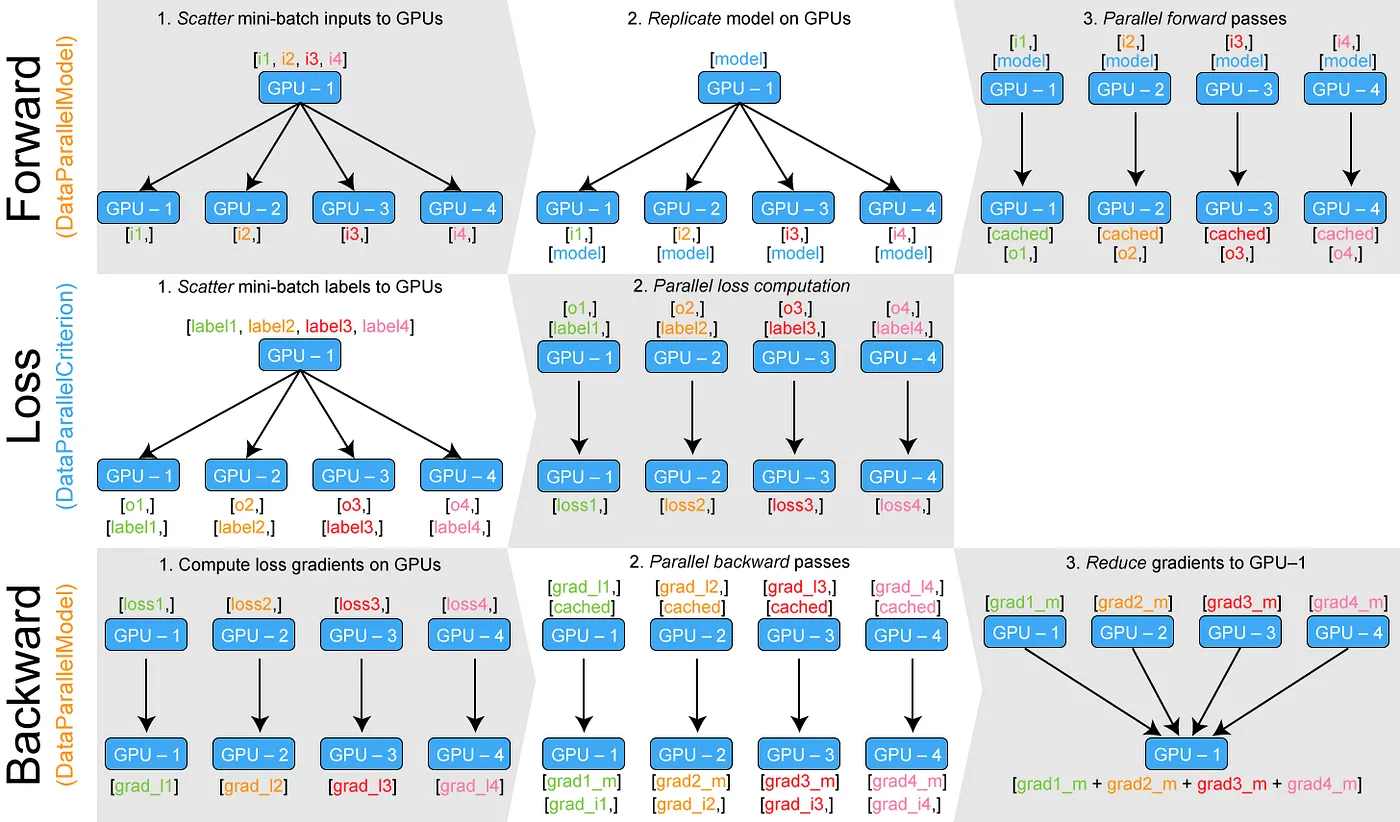
图 1 Data Parallelism 的前向、Loss 与反向传播过程。来源:Infrasys-AI/AIInfra · 数据并行。
前向和反向计算结束后,各张 GPU 得到不同梯度,需要通过 Gradient Synchronization(梯度同步)保持参数更新一致。
典型操作是 All-Reduce。假设两张 GPU 得到的梯度分别为 2 和 4,平均之后两边都使用 3 更新参数。
DP 的优点是思路简单,也能很好地扩大训练吞吐。但它没有解决“模型本身太大”的问题,因为每张 GPU 仍然保存完整模型。
如果单个模型需要 200 GB 显存,而 GPU 只有 80 GB,再增加数据并行卡数也不会让模型突然装进去。
Tensor Parallelism
当完整模型已经放不进单张 GPU 时,模型本身必须被切开。
Tensor Parallelism(张量并行,TP)通常把一个大矩阵或算子的计算拆到多张 GPU 上。在线性层
中,可以把权重矩阵按列拆成:
两张 GPU 分别计算 XW₁ 和 XW₂,再组合成完整输出。
这也是 Megatron-LM 里非常重要的一类并行方式。
TP 解决了单个算子太大的问题,但切开以后,中间结果需要在 GPU 之间频繁交换。模型越依赖跨卡通信,网络带宽和通信拓扑就越重要。
Pipeline Parallelism
Pipeline Parallelism(流水线并行,PP)采用另一种划分方式:不同 GPU 保存不同层。
例如一个 40 层 Transformer 可以被分成四段:
GPU0:Layer 1 ~ 10
GPU1:Layer 11 ~ 20
GPU2:Layer 21 ~ 30
GPU3:Layer 31 ~ 40
一条数据必须依次经过这些 Stage。如果只放一个 Batch,GPU1 等待 GPU0、GPU2 又等待 GPU1,大量时间会浪费在空闲上。
因此 Batch 通常会继续切成多个 Micro-batch(微批次),让不同 Stage 同时处理不同 Micro-batch。
时间 →
GPU0  MB1 MB2 MB3 MB4
GPU1      MB1 MB2 MB3 MB4
GPU2          MB1 MB2 MB3 MB4
GPU3              MB1 MB2 MB3 MB4
即便如此,流水线开头和结尾仍然存在空闲区间,也就是 Pipeline Bubble(流水线气泡)。增加 Micro-batch、1F1B 调度、Interleaved Pipeline 和更合理的 Stage 划分,本质上都在减少这部分空闲。
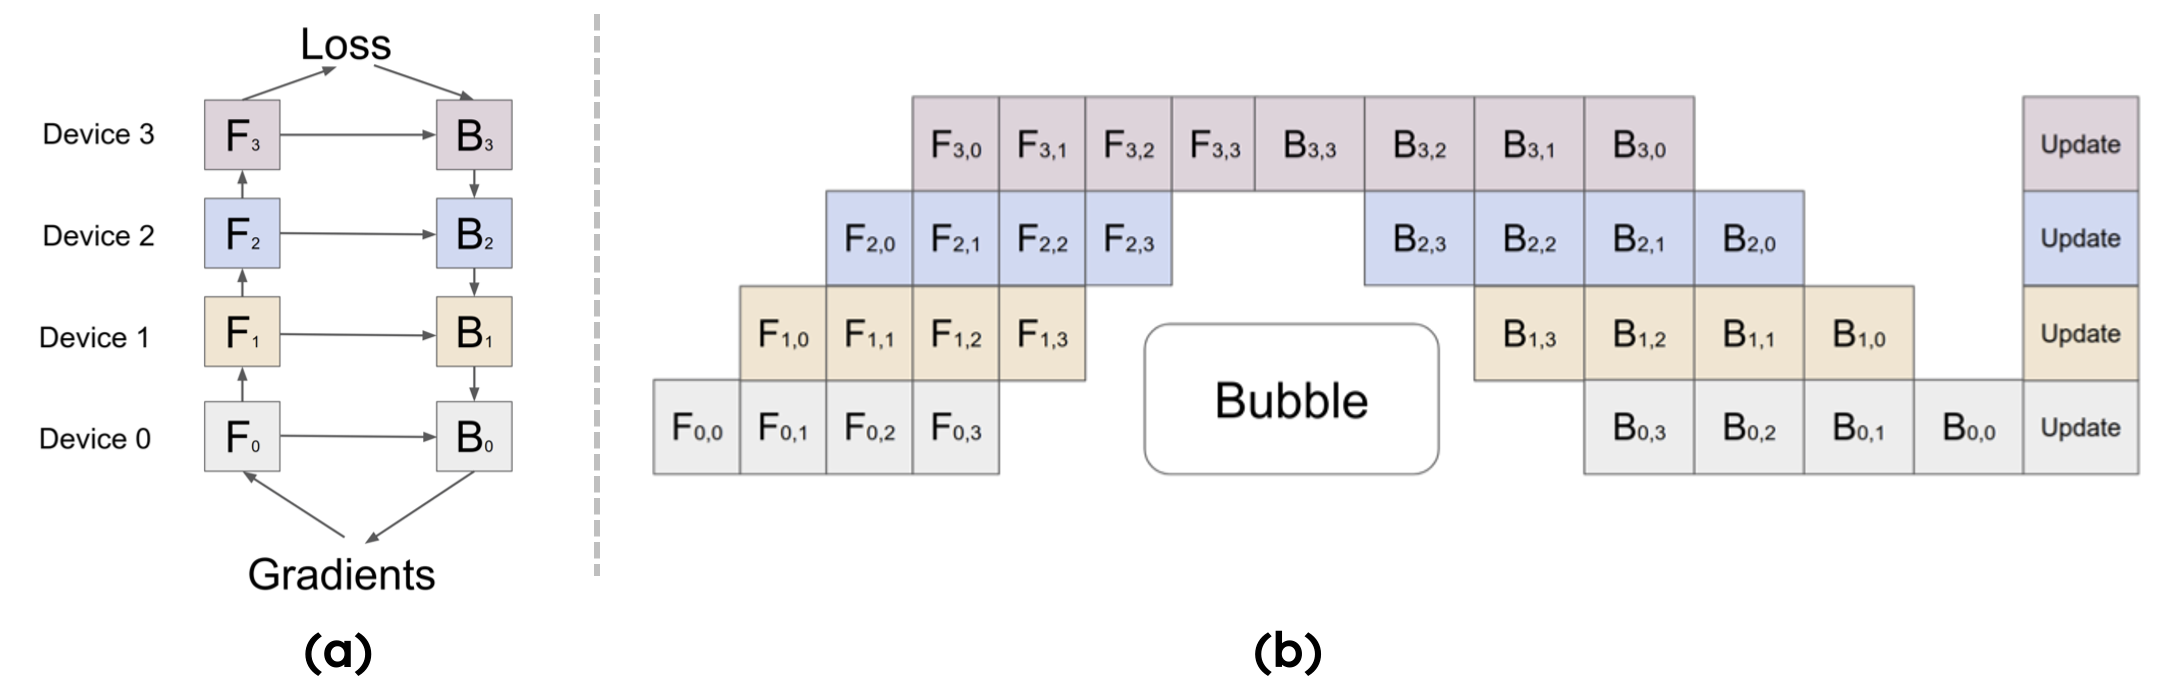
图 2 Pipeline Parallelism 中的 Micro-batch 调度与 Bubble。来源:Infrasys-AI/AIInfra · PP 流水并行原理。
3D Parallelism
大规模训练通常不会只选择一种并行方式,而是同时使用 DP、TP 和 PP。
例如 1024 张 GPU 可以组织成:
这种组合通常被称为 3D Parallelism(三维并行)。
并行策略并不是“卡越多越快”。每多拆一层,就会引入新的通信、同步和负载均衡问题。后面的很多 AI Infra 优化,其实都在处理这些额外代价。
3.多卡通信
DP 需要同步梯度,TP 要交换中间 Tensor,MoE 还会在不同专家之间重新分发 Token。多 GPU 训练最终都绕不开通信。
NVIDIA 生态中常见的通信库是 NCCL(NVIDIA Collective Communications Library)。训练里最常看到的几种集合通信包括:
- All-Reduce:多张 GPU 的数据做归约,并把结果返回给所有 GPU;
- All-Gather:每张 GPU 持有一部分数据,最后所有 GPU 都拿到完整数据;
- Reduce-Scatter:先做归约,再把结果切分到不同 GPU;
- All-to-All:每张 GPU 都向其他 GPU 发送不同的数据块,MoE 中尤其常见。
通信性能还取决于硬件拓扑。同一台服务器内部的 GPU 通常可以通过 NVLink 等高速互联通信;不同服务器之间则更依赖 InfiniBand、RoCE 等数据中心网络。
因此“用了 8 张卡”只是数量信息。8 张卡是怎样连接的、跨不跨节点、通信是否能与计算重叠,都会影响最终吞吐。
Communication-Compute Overlap(通信与计算重叠)也由此出现:GPU 在计算当前部分时,同时传输后续计算需要的数据,尽量把通信延迟藏在计算时间里。
4.显存优化
模型参数增加以后,显存是最直接的限制之一。但训练显存不能只看参数量。
粗略地说,一次训练会同时占用:
这解释了一个常见现象:模型权重明明能装进显存,训练时却立刻 OOM。
ZeRO
普通 Data Parallelism 中,每张 GPU 都保留完整的模型状态。卡数增加以后,很多显存实际上存放的是重复内容。
ZeRO(Zero Redundancy Optimizer)的思路就是减少这些冗余副本。
ZeRO-1 先切分 Optimizer States(优化器状态);ZeRO-2 再切分 Gradients(梯度);ZeRO-3 连 Parameters(参数)也一起切分。
            Parameters   Gradients   Optimizer States
ZeRO-1        完整          完整           切分
ZeRO-2        完整          切分           切分
ZeRO-3        切分          切分           切分
假设模型参数量为 Ψ,FP16 参数需要 2Ψ Byte,FP16 梯度需要 2Ψ Byte,优化器相关状态记为 KΨ,传统数据并行每张 GPU 的这部分状态大致需要:
如果取 K=12,就是 16Ψ。对于 7.5B 参数模型,这部分状态大约为 120 GB。
如果数据并行一共有 N_d 张 GPU,ZeRO-3 会继续把这些状态分片。理想化情况下,每张 GPU 保存的模型状态可以近似写成:
64 张 GPU 时,120 GB 被分片后约为 1.875 GB。
这里的数字只描述被 ZeRO 分片的模型状态,不代表完整训练显存,因为 Activations、临时 Buffer、通信 Buffer 等仍然存在。
ZeRO-3 的代价也很直接:参数不再完整地放在本地,需要时必须从其他 GPU 获取。显存下降通常意味着通信需求上升。
这类 Trade-off(权衡) 几乎贯穿整个 AI Infra:省下来的东西往往会在另一个资源维度上付出代价。
FSDP 与 ZeRO-3
PyTorch 的 FSDP(Fully Sharded Data Parallel)同样会把参数、梯度和优化器状态分片到多个 Rank 上,因此经常和 ZeRO-3 放在一起比较。
两者的实现和工程接口并不完全相同,但学习阶段可以先抓住共同点:Data Parallel 不一定意味着每张 GPU 都永久保留一整份模型状态。
Offload
另一条思路是 Offload(卸载)。暂时不需要的参数或优化器状态可以从 GPU HBM 移到 CPU RAM,甚至 NVMe SSD。
GPU HBM ↔ CPU RAM ↔ NVMe SSD容量变大了,但访问速度明显下降,而且数据搬运会经过 PCIe 或网络。
因此 Offload 解决的是“能不能放下”,不一定解决“能不能跑得快”。如果数据来不及搬回 GPU,节省下来的显存会转化成等待时间。
Gradient Accumulation
Gradient Accumulation(梯度累积)解决的是另一个常见显存问题。
如果一次只能放 8 条样本,但希望有效 Batch Size 为 32,可以连续做 4 次前向和反向,把梯度累积起来,最后再执行一次参数更新。
它减少的是单次需要装入显存的数据量,但计算并没有消失,因此不能把梯度累积理解成免费加速。
5.单卡性能优化
解决 OOM 只代表程序能运行。AI Infra 更难的一部分是:程序能跑,但 GPU 没有真正跑满。
一种常见观察指标是 MFU(Model FLOPs Utilization,模型 FLOPs 利用率)。如果硬件理论上能提供 1000 TFLOPS,而模型训练过程中真正用于模型计算的有效吞吐约为 400 TFLOPS,可以粗略理解为 MFU 约 40%。
GPU 跑不满的原因很多:等数据、等通信、等其他 GPU、Pipeline Bubble、Kernel 太碎、显存访问慢、负载不均衡,甚至资源调度本身不合理。
这些问题看似分散,最终都指向一件事:时间到底花在计算上,还是花在搬数据和等待上。
Kernel Fusion
GPU 上的运算通常由 Kernel 执行。一个模型算子如果被拆成很多小 Kernel,会产生 Kernel Launch 开销,也可能让中间结果反复写入 HBM、再重新读出。
例如 LayerNorm、Dropout 和 Add 如果分别执行,中间 Tensor 会产生更多读写。Kernel Fusion(算子融合)把多个操作合并到更少的 Kernel 中,可以减少 Launch 次数和显存访问。
它说明了一个很重要的系统视角:FLOPs 相同,并不意味着运行时间相同。
FlashAttention
标准 Attention 为:
序列长度为 N 时,中间 Attention Matrix 的规模随 N² 增长。传统实现的问题不仅是矩阵大,还包括中间结果在 HBM 和片上存储之间频繁搬运。
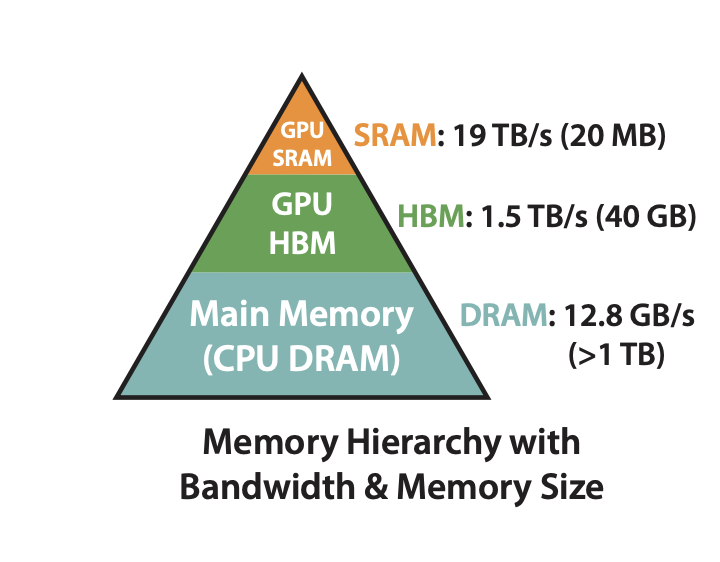
图 3 GPU Memory Hierarchy:容量更大的内存通常离计算核心更远、带宽也更低。来源:Infrasys-AI/AIInfra · Flash Attention。图中数值对应课程采用的 A100 示例。
FlashAttention 没有改变 Attention 的数学定义,而是重新设计计算顺序,通过 Tiling(分块)尽量让中间计算停留在片上 SRAM / Shared Memory 中,减少 HBM 的读写次数。
这类方法通常被称为 IO-Aware Algorithm(I/O 感知算法)。
我觉得 FlashAttention 很适合作为理解 AI Infra 的例子:算法公式没有变,性能提升来自对硬件 Memory Hierarchy(内存层次结构)的重新利用。很多所谓“系统优化”并不是在模型外面加一层工具,而是直接进入算子的实现方式。
Mixed Precision
FP32 每个数需要 4 Byte,FP16 / BF16 通常需要 2 Byte。使用更低精度可以减少显存占用,也能提高 Tensor Core 的有效吞吐。
但数值范围和精度降低以后,会出现 Overflow(溢出)、Underflow(下溢)和数值不稳定,因此训练通常不是简单地把所有 Tensor 全部改成同一种低精度。
AMP(Automatic Mixed Precision,自动混合精度)会根据算子类型选择合适精度。在 PyTorch 中常见写法是:
with torch.autocast(device_type="cuda"):
    output = model(x)
低精度训练的关键不只是“数字更小”,而是在速度、显存和稳定性之间寻找平衡。
Quantization
Quantization(量化)通常在推理阶段更常见,例如把 FP16 权重转换为 INT8 或 INT4。
从 16-bit 降到 4-bit 时,忽略额外的量化元数据后,参数存储理论上约为原来的四分之一。
PTQ(Post-Training Quantization,训练后量化)是在模型训练完成后再量化;QAT(Quantization-Aware Training,量化感知训练)则在训练过程中模拟量化误差,让模型提前适应低比特表示。
量化进一步说明:模型性能不仅由参数数量决定,参数“以什么格式被保存和计算”本身也是 Infra 的设计空间。
Hardware-Aware Optimization
同一个算法在不同 GPU 上不一定有相同的最优实现,因为 Tensor Core、显存带宽、Cache、指令集和通信能力都可能不同。
Hardware-Aware Optimization(硬件感知优化)因此关注“算法怎样映射到具体硬件”。Triton、CUTLASS、TensorRT-LLM、TVM、XLA 等工具都和这一问题有关,只是位于技术栈的不同位置。
学习 CUDA 时经常会遇到的 Roofline Model(屋顶线模型)也属于这一视角:一个 Kernel 的瓶颈究竟更接近计算能力,还是更接近内存带宽。
MoE 与稀疏计算
Dense Model(稠密模型)通常会让每个 Token 经过同一组主要参数。MoE(Mixture of Experts,混合专家模型)则引入多个 Expert,由 Router 为每个 Token 选择少量专家。
Token
  ↓
Router
  ↓
Expert 3 + Expert 7
因此 MoE 可以让 Total Parameters(总参数量)远大于每个 Token 实际使用的 Active Parameters(激活参数量)。
这听起来像是“参数更多,但计算没有同比增加”,但系统复杂度会明显上升。
如果大量 Token 都被路由到 Expert 1,而 Expert 2 几乎没有请求,就会出现 Load Imbalance(负载不均衡)。专家分布在不同 GPU 上时,Token 还需要通过 All-to-All Communication 在设备之间重新分发。
于是模型结构里的一个 Router,会继续影响 Expert Placement、Expert Parallelism、通信拓扑和负载均衡。
MoE 很能说明模型算法和 Infra 之间的边界并不固定。算法改变了计算图,系统就必须重新决定数据放在哪里、什么时候移动、怎样避免某些 GPU 变成热点。
6.预训练与后训练
大模型训练并不是“预训练一次就结束”。Pre-training、SFT、RLHF / DPO 的计算模式不同,对系统的要求也不完全一样。
Pre-training
Pre-training(预训练)的目标是从大规模数据中学习通用语言模式、知识和一定的推理能力,最后得到 Base Model(基座模型)。
GPT 类模型通常采用 CLM(Causal Language Modeling,因果语言建模),根据前面的 Token 预测下一个 Token:
整段序列可以写成:
BERT 一类模型更典型的目标是 MLM(Masked Language Modeling,掩码语言建模),根据左右上下文恢复被 Mask 的位置。
CLM 和 MLM 属于训练目标的区别;DP、TP、ZeRO、FlashAttention 属于系统如何执行训练。两层概念经常同时出现,但不要混成同一个维度。
SFT 与 LoRA
SFT(Supervised Fine-Tuning,监督微调)使用“输入—目标输出”形式的数据,让 Base Model 更稳定地按照任务要求产生回答。
如果模型很大,全参数微调需要更新全部权重,显存和存储成本都很高,因此出现了 PEFT(Parameter-Efficient Fine-Tuning,参数高效微调)。
LoRA(Low-Rank Adaptation,低秩适配)是其中最常见的方法之一。
假设原权重为 W,LoRA 不直接训练一个完整的 ΔW,而是使用低秩矩阵:
其中:
最终得到:
当 d 很大而 r 很小时,需要训练的参数会显著少于完整权重矩阵。
PEFT 里还包括 Adapter、Prefix Tuning、Prompt Tuning 等方法。它们的共同目标不是让模型“变小”,而是减少每个微调任务需要单独更新和保存的参数量。
从 Infra 角度看,这会进一步影响 GPU Sharing、任务调度、Memory Isolation、Checkpoint 和 Job Queue:同一批 GPU 有机会同时服务更多微调任务。
RLHF
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)比普通 SFT 更复杂。
典型流程会先收集人类偏好,再训练 Reward Model,并使用强化学习优化 Policy。工程中可能同时出现 Policy Model、Reward Model、Reference Model、Rollout、Inference 和 Training。
这意味着一次“训练”已经不再是单模型的前向和反向,而更像多个模型组成的数据生产—评估—更新流水线。
DPO
DPO(Direct Preference Optimization,直接偏好优化)直接利用 Preferred Answer 和 Rejected Answer 构成的偏好数据优化模型。
相比经典 RLHF 流程,它可以省去独立 Reward Model 和一部分复杂的强化学习训练过程,因此工程链路更短。
这并不意味着 DPO 等价于“RLHF 的简单版本”,两者的优化形式不同。对 Infra 学习而言,更值得关注的是:训练算法一旦改变,所需模型数量、采样方式、显存占用和数据流都会随之变化。
7.模型评估与 Evaluation Infra
模型训练完成以后,问题从“Loss 是否下降”变成“能力到底有没有提升”。
Perplexity(困惑度,PPL)可以衡量语言建模任务中的预测质量,常见形式为:
在使用平均交叉熵 Loss 的常见设置下,也常写成:
PPL 降低说明语言建模目标上的预测变好,但不能单独代表聊天、推理、安全或工具调用能力。
因此现代 LLM 会继续使用不同 Benchmark:
- MMLU:覆盖多个学科的知识与推理;
- GPQA:偏高难度科学知识与推理;
- SWE-bench:要求模型理解代码仓库、修改代码并通过测试;
- BLEU / ROUGE:仍会用于翻译、摘要等有参考答案的文本任务;
- Human Evaluation、LLM-as-a-Judge 和 Task-specific Metrics:处理更开放的生成任务。
当模型有大量 Checkpoint、每个 Checkpoint 都要运行一批 Benchmark 时,评估本身也会消耗大量 GPU 和存储资源。
于是 Evaluation Infra 会涉及批量调度、结果缓存、Benchmark 管理、日志、版本追踪和可视化。
它和软件工程里的 CI/CD 有一点相似:模型和数据变化以后,需要自动训练、自动测试、记录结果,再决定是否继续迭代。
Data → Train → Evaluate → Deploy → Monitor
  ↑                                  ↓
  └──────────── Collect Data ────────┘
这也是 MLOps / LLMOps 的一部分。
8.推理 Infra
训练一个模型可能发生几次,但上线以后,一份模型可能需要响应数以百万甚至更多的请求。
因此推理阶段关注的问题和训练并不完全相同。训练更关心大规模并行、反向传播和参数状态;Serving(服务)更关心 Latency(延迟)、Throughput(吞吐)、并发请求和单位 Token 成本。
KV Cache
Decoder-only LLM 每生成一个新 Token,都需要使用前面 Token 的 Key / Value。为了避免每一步都重新计算历史 Token 的 K、V,中间结果会被保存在 KV Cache 中。
请求越多、上下文越长,KV Cache 占用越大。推理时“模型权重能放下”并不代表“还能同时服务很多长上下文请求”。
因此 KV Cache 的管理成为推理 Infra 的核心问题之一。
PagedAttention
vLLM 的 PagedAttention 把 KV Cache 切成固定大小的 Block,用类似虚拟内存分页的方式管理这些块。
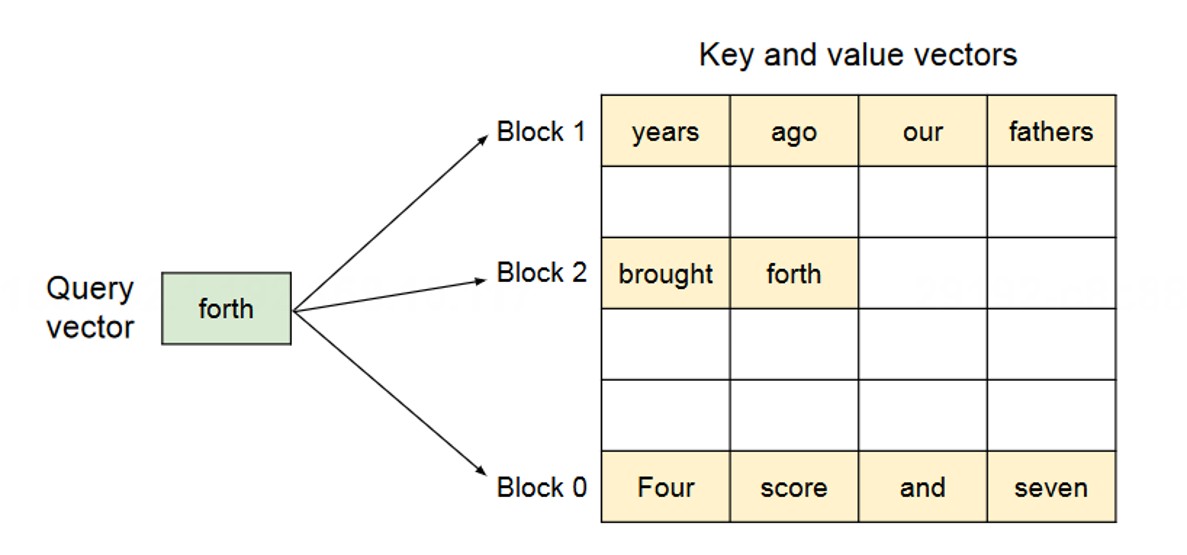
图 4 PagedAttention 按 Block 组织 KV Cache。来源:Infrasys-AI/AIInfra · Paged Attention 原理;PagedAttention 原始方法见 Kwon et al., SOSP 2023。
这样做可以减少连续大块显存分配带来的碎片,也更方便不同请求之间共享部分 KV Cache。
这里和 FlashAttention 有一个很有意思的区别:FlashAttention 主要优化 Attention 计算过程中的数据搬运;PagedAttention 更关注 Serving 场景下 KV Cache 怎样被组织和分配。
名字里都有 Attention,但解决的问题并不一样。
Continuous Batching
传统 Batch 往往等一批样本一起进入、一起结束。但 LLM 请求生成长度不同,有的几十个 Token 就结束,有的还要继续生成几百个 Token。
如果强制整批一起结束,已经完成的请求会占着位置等待其他请求。
Continuous Batching(连续批处理)允许完成的请求及时离开,同时把新的请求加入当前执行批次,让 GPU 更持续地保持较高利用率。
Prefix Caching
很多请求可能共享相同 System Prompt、长文档前缀或多轮对话历史。Prefix Caching(前缀缓存)会复用这些公共前缀对应的计算结果,减少重复 Prefill。
它把“请求之间是否存在相同上下文”变成了新的系统优化空间。
Speculative Decoding
自回归生成最大的限制之一是 Token 必须逐步生成。Speculative Decoding(投机解码)引入较小的 Draft Model,一次提出多个候选 Token,再由 Target Model 并行验证。
如果候选经常被接受,就可以减少大模型逐 Token 执行的次数。
这类方法真正优化的是 Decode 路径上的串行性,而不是单纯把每个 Token 的矩阵乘做得更快。
Disaggregated Serving
Prefill 和 Decode 的资源特征并不完全一样。Prefill 通常计算量更密集,Decode 则更容易受到 KV Cache 和内存访问影响。
Disaggregated Serving(分离式推理)尝试把两个阶段放到不同资源池中,让硬件配置和调度策略分别适配它们。
推理系统里常见的框架包括 vLLM、SGLang、TensorRT-LLM 和 TGI。它们并不是同一种工具的简单替代品,但都会围绕 Batch、KV Cache、Kernel、并行和调度做大量工作。
9.AI Infra 技术栈
前面的概念如果只按名字背,很快会重新散掉。按问题看会稳定很多。
模型太大,单卡放不下,会引出 TP、PP、ZeRO、FSDP、Offload。
卡已经很多,但速度没有按比例提升,会继续遇到 NCCL、通信拓扑、Pipeline Bubble、Communication-Compute Overlap 和负载均衡。
GPU 理论算力很高,但实际利用率低,需要看 Kernel、Memory Hierarchy、Kernel Fusion、FlashAttention、Roofline Model 和 Hardware-Aware Optimization。
模型开始使用 MoE,系统又要处理 Router、Expert Placement、Expert Parallelism 和 All-to-All。
模型从训练进入部署,问题会转向 KV Cache、PagedAttention、Continuous Batching、Prefix Caching、Speculative Decoding、Quantization 和 Disaggregated Serving。
因此 AI Infra 不是某一个框架,也不等于 CUDA。它更像一组贯穿模型生命周期的系统问题:计算怎样切分,数据放在哪里,什么时候搬运,谁和谁通信,有限资源怎样调度。
10.学习路线
目前更适合把学习路线分成四层,而不是一次把所有框架都学完。
单 GPU
这一层重点放在:
- GPU 架构基础
- CUDA
- Memory Hierarchy
- Kernel
- Roofline Model
- Kernel Fusion
- FlashAttention
目标不是马上手写复杂 Kernel,而是建立“计算量、显存访问、并行度”之间的感觉。
多 GPU
重点放在:
- PyTorch DDP
- NCCL
- All-Reduce / All-Gather / Reduce-Scatter
- Tensor Parallel
- Pipeline Parallel
- ZeRO
- FSDP
到这一阶段,DP、TP、PP 不应该只剩定义,而应该能够解释它们分别增加了哪些通信。
训练系统
继续看:
- Megatron-LM
- DeepSpeed
- Checkpoint
- Fault Tolerance
- MoE
- Expert Parallelism
- 资源调度和训练监控
这一层开始把单个训练脚本放回真实集群里理解。
推理系统
重点放在:
- KV Cache
- PagedAttention
- Continuous Batching
- Prefix Caching
- Speculative Decoding
- Quantization
- vLLM
- SGLang
这一层和后续想继续做的推理引擎方向连接最直接,也更容易找到可以单独实验和测量的问题。
11.知识总结
- AI Infra 的主线不是工具,而是 Compute、Memory、Communication、Storage 和 Scheduling 之间的约束。
- DP 拆数据,TP 拆模型内部算子,PP 按层拆模型;大规模训练通常组合三者。
- ZeRO / FSDP 通过分片减少重复模型状态,但显存节省通常会带来更多通信。
- GPU 性能不只取决于 FLOPs。Kernel Launch、HBM 访问和通信等待都可能成为主要瓶颈。
- FlashAttention 的价值在于 IO-Aware:数学上的 Attention 不变,数据搬运方式改变。
- MoE 让模型参数变得稀疏激活,同时把路由、负载均衡和 All-to-All 带进系统层。
- 训练和推理的瓶颈并不相同。推理阶段尤其需要关注 KV Cache、Batching、Latency 和 Throughput。
- 很多 AI Infra 技术最终都在做 Trade-off:显存、计算、通信、延迟、吞吐和成本之间很少存在免费的优化。
12.参考资料
- ZOMI.
- Rajbhandari, S. et al. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. SC 2020 / arXiv:1910.02054.
- Shoeybi, M. et al. Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism. arXiv:1909.08053.
- Dao, T. et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022 / arXiv:2205.14135.
- Hu, E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022 / arXiv:2106.09685.
- Ouyang, L. et al. Training Language Models to Follow Instructions with Human Feedback. NeurIPS 2022 / arXiv:2203.02155.
- Rafailov, R. et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS 2023 / arXiv:2305.18290.
- Kwon, W. et al. Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP 2023 / arXiv:2309.06180.
13.版权与引用
本文是个人学习 AI Infra 过程中整理的技术笔记,主要参考 Infrasys-AI/AIInfra 开源课程,并结合原始论文与个人理解重新组织内容。本文不代表 AIInfra 官方内容。 AIInfra 仓库的课程文档与相关素材以其 LICENSE 为准,采用 Apache License 2.0;代码部分另见 LICENSE-CODE。原项目版权归 ZOMI 及相关贡献者所有。 本文正文使用了少量 AIInfra 课程插图,均在对应图下注明具体课程页面。当前 Markdown 采用课程站点的远程图片链接,未对图片内容进行改绘。若图片在原课程中另有论文、厂商文档或第三方来源,发布时应继续保留原始来源,不以 AIInfra 的引用替代原作者信息。
评论
欢迎交流想法,也欢迎留下问题。
正在加载评论…
无需登录,昵称和邮箱为必填项。邮箱不会公开,仅用于身份区分与回复通知;服务端会保留必要的请求时间、IP 和设备信息,用于反垃圾、限流、封禁与安全审计。